
Avec Gemini 4 Carbon, Google DeepMind entend repousser les limites de ses modèles de raisonnement, notamment dans le développement logiciel, les workflows agentiques et la cybersécurité. Présenté le 28 octobre 2026, ce nouveau modèle occupe déjà la première place de l’Artificial Analysis Intelligence Index. Mais ses performances sont-elles aussi impressionnantes que ce classement le laisse penser ?
Gemini 4 Carbon, le meilleur modèle IA dans les benchmarks ?
Deux semaines après l’arrivée de Gemini 4 Argon, Google a dévoilé Carbon comme étant le modèle le plus performant de sa gamme, voire le meilleur modèle IA du marché.
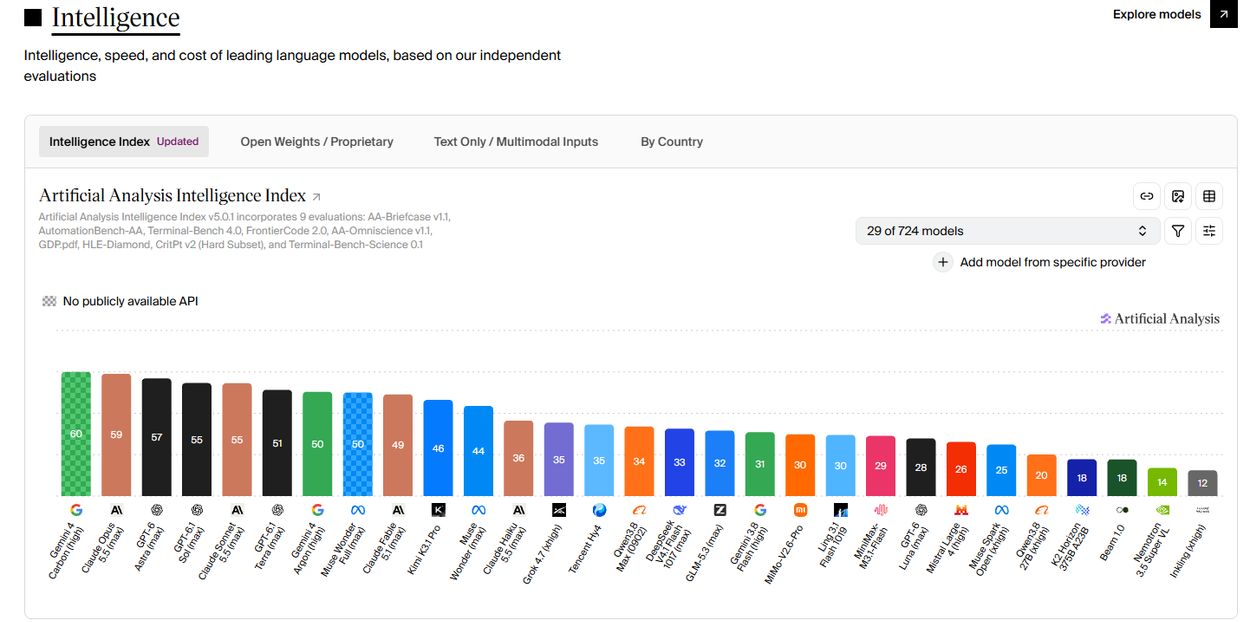
Avec 60 points sur l’Artificial Analysis Intelligence Index v5.0.1, il devance Claude Opus 5.5 d’Anthropic (59 points) et GPT-6 Astra d’OpenAI (57 points). Son prédécesseur, Argon, se situe plus loin, avec 50 points, à égalité avec Muse Wonder Full de Meta. Ce classement indépendant agrège neuf évaluations portant notamment sur le raisonnement, les connaissances, le développement et l’exécution de tâches complexes.
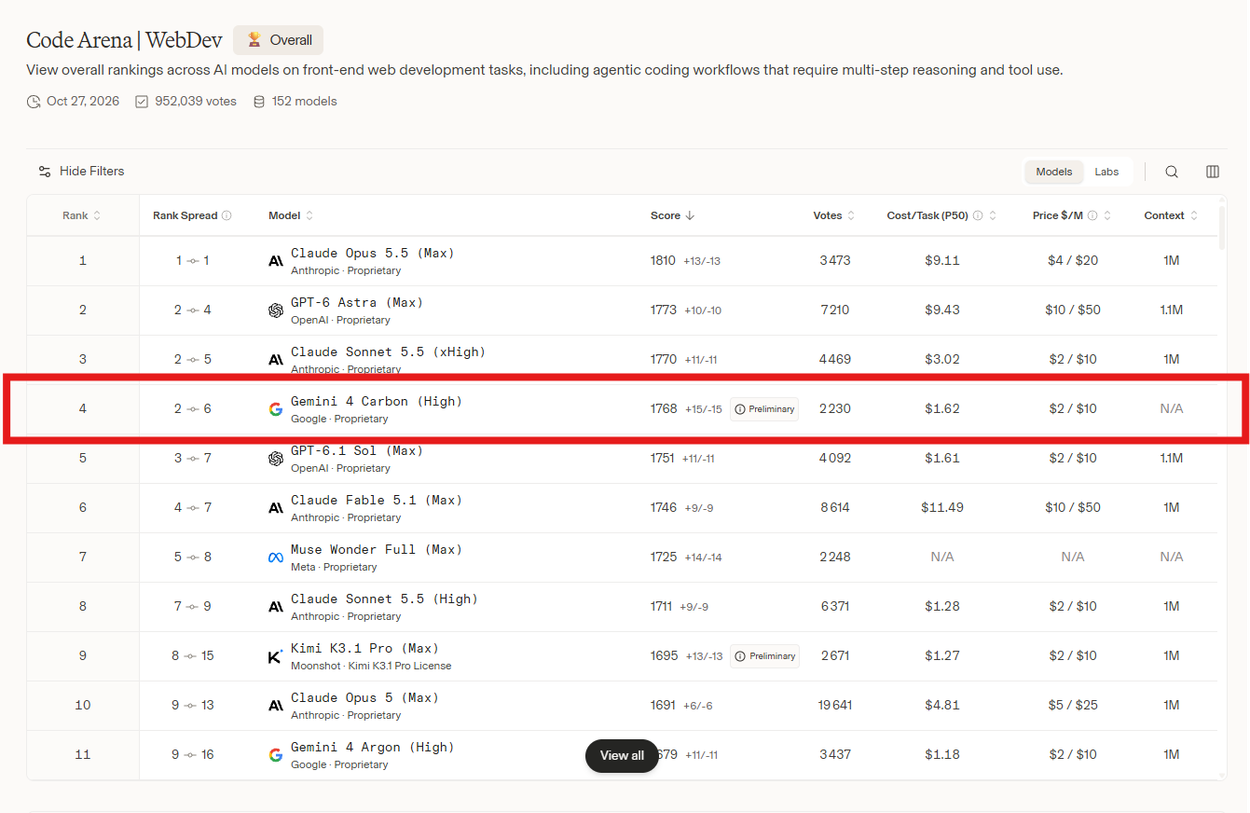
Cette première place ne signifie toutefois pas que Carbon surpasse systématiquement ses concurrents. Sur WebDev Arena, consacré au développement web, il n’arrive qu’en quatrième position, malgré un gain de 89 points Elo par rapport à Argon. Artificial Analysis souligne également qu’il ne domine « que » 4 des 9 évaluations de son indice, notamment dans le raisonnement complexe, les connaissances scientifiques et l’automatisation.
Le modèle présente néanmoins des résultats particulièrement élevés en cybersécurité. Selon les évaluations publiées par Google, réalisées sans garde-fous, il atteindrait 88,2 % sur SEC-bench Pro, qui mesure la détection de vulnérabilités dans des logiciels existants, 54,8 % sur ExploitGym, consacré à la validation des possibilités d’exploitation des failles, et 71 % sur CWE-bench, qui évalue la production de correctifs. Carbon couvre ainsi plusieurs étapes de la protection des systèmes informatiques, de la découverte des vulnérabilités à leur validation et à la correction du code concerné.
Ces résultats reposent sur des benchmarks externes, mais les scores communiqués pour Carbon proviennent toutefois de Google. Le modèle n’a par ailleurs pas encore de résultat dans le Cyber Index d’Artificial Analysis, un autre classement indépendant qui aurait permis de comparer ses capacités de cyberdéfense à celles de ses concurrents.
Les capacités agentiques de longue durée de Gemini 4 Carbon
Au-delà des performances brutes, Google destine Carbon aux tâches agentiques de longue durée. Le modèle doit pouvoir prendre en charge des opérations complexes nécessitant de nombreuses étapes, sans intervention humaine constante. Les équipes de Google DeepMind affirment notamment l’avoir observé travailler plusieurs jours consécutifs sur de grandes bases de code, afin d’identifier l’origine de bugs puis de les corriger.
Cette capacité s’accompagne d’améliorations dans la fiabilité des réponses. D’après les évaluations internes de Google, Carbon produirait environ 2 fois moins d’affirmations non étayées qu’Argon. Il réduirait également de 26 % les dépassements du périmètre fixé par l’utilisateur et de 29 % les réponses qui ne vont pas suffisamment loin dans l’exécution des consignes. En cas d’ambiguïté, il est également entraîné à rechercher les informations manquantes et à signaler les éventuelles contradictions avant de poursuivre une tâche.
Comme évoqué précédemment, la sécurité constituerait aussi un point fort du modèle. Sur le benchmark de Gray Swan consacré aux injections indirectes de prompt (« indirect prompt injection »), aucune des attaques testées n’a abouti, contre un taux de réussite de 0,7 % pour Argon. Carbon reprend aussi les mécanismes de protection de son prédécesseur, notamment la détection des usages malveillants et la surveillance de son comportement.
Malgré ces précautions, ses capacités offensives potentielles expliquent pourquoi Google réserve son accès initial à des spécialistes de la cyberdéfense. Le modèle est progressivement proposé à des partenaires sélectionnés dans le cadre du programme Fairwind, avant un éventuel élargissement aux développeurs, aux entreprises et au grand public. Aucune date précise n’est annoncée pour le déploiement à un plus large public.
Un modèle IA coûteux et déjà concurrencé (GPT Fat) ?
Cette puissance a un prix. Pendant sa période de lancement, Gemini 4 Carbon est facturé 2 $ par million de tokens en entrée et 10 $ en sortie. Les entrées mises en cache bénéficient d’une réduction de 95 %. Ces tarifs promotionnels doivent ensuite doubler, pour atteindre respectivement 4 et 20 $. À ces conditions normales, Artificial Analysis estime le coût d’une tâche de son Intelligence Index à 7,76 $, contre 7,68 $ pour Argon. Carbon consomme donc légèrement plus de ressources, malgré un score nettement supérieur.
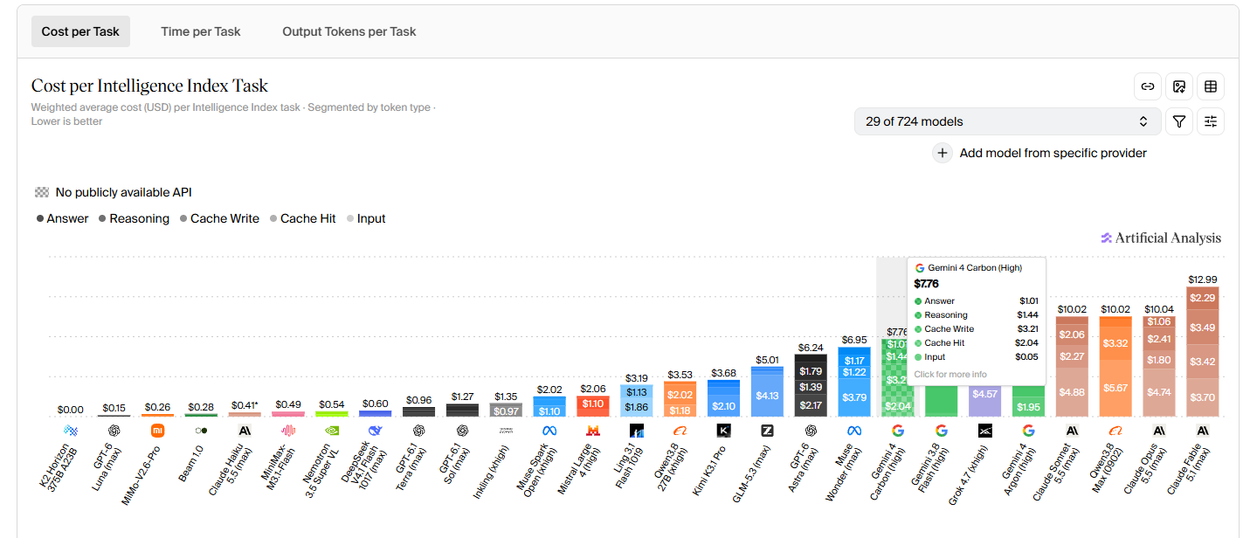
La comparaison avec les concurrents reste néanmoins nuancée. Claude Opus 5.5 revient à environ 10 $ par tâche sur le même indice, tandis que GPT-6.1 Sol d’OpenAI affiche seulement 1,27 $ (mais avec un score d’Intelligence de 55 points). Google doit donc encore progresser sur l’efficience pour rendre son modèle économiquement viable à grande échelle.
Sundar Pichai, PDG de Google, reconnaît d’ailleurs indirectement cette difficulté : l’entreprise travaille sur des versions allégées de Carbon afin de pouvoir les déployer auprès d’un milliard d’utilisateurs, sans sacrifier excessivement la qualité ni la rapidité.
La concurrence ne compte pas attendre. Après la présentation de Large 4 par Mistral, OpenAI a également laissé entrevoir une nouvelle évolution de ses modèles. Le 3 novembre, Thibault Sottiaux, ingénieur travaillant sur ChatGPT et Codex, a publié sur X le message énigmatique « Le GPT Fat », qui fait référence aux surnoms des modèles de Mistral.
L’identifiant GPT-6.2 Astra avait par ailleurs été repéré dans des statistiques d’utilisation de Codex. Rien ne confirme encore officiellement une sortie imminente, mais ces indices alimentent les spéculations sur une nouvelle réponse d’OpenAI aux derniers modèles de Google et de ses concurrents.
Gemini 4 Carbon s’impose donc comme un sérieux candidat au sommet des modèles de raisonnement, particulièrement dans la cybersécurité et les tâches complexes. Reste à savoir si Google parviendra à rendre ses capacités accessibles et rester dans la course avant que ses concurrents ne reprennent l’avantage.
Certains liens de cet article peuvent être affiliés.
