
Claude Opus 5.5 et GPT-6.1 Sol ciblent les utilisateurs qui attendent d’une intelligence artificielle qu’elle réalise des tâches complexes, de la programmation à l’analyse documentaire en passant par l’automatisation de workflows.
Mais leurs performances et leurs tarifs ne les placent pas sur un pied d’égalité. Le modèle d’OpenAI privilégie le rapport entre coût et résultats, tandis que celui d’Anthropic se distingue dans plusieurs évaluations exigeantes. Voici comment les utiliser et choisir selon vos besoins.
Claude Opus 5.5 et GPT-6.1 Sol : quelles différences ?
Claude Opus 5.5, développé par Anthropic, est conçu pour le codage avancé, les tâches intellectuelles et les agents capables de travailler sur plusieurs étapes. Il dispose d’un mécanisme de réflexion adaptative et peut consacrer davantage de ressources aux problèmes difficiles.
GPT-6.1 Sol, lancé par OpenAI le 29 septembre 2026, est une version optimisée pour les travaux professionnels, la programmation complexe et l’utilisation d’outils. Il appartient à la famille GPT-6, dont GPT-6 Astra constitue le modèle haut de gamme, mais coûte nettement moins cher que ce dernier.
Les deux modèles acceptent du texte et des images en entrée, disposent d’une fenêtre de contexte d’environ un million de tokens et peuvent générer jusqu’à 128 000 tokens en sortie. Cette capacité permet notamment de travailler sur de longs documents ou des bases de code volumineuses, même si la taille du contexte ne garantit pas que toutes les informations seront exploitées correctement.
Anthropic vs OpenAI : quelle entreprise propose le modèle le plus performant ?
Les évaluations indépendantes d’octobre 2026 mettent en lumière des profils complémentaires.
Sur l’indice d’intelligence global d’Artificial Analysis évalué à effort maximal, Claude Opus 5.5 (avec son mécanisme de repli) occupe la première place avec un score de 58, devançant Claude Fable 5.1 (53), GPT-6 Astra (53), Gemini 4 Argon (53) et Muse Wonder de Meta, à égalité avec GPT-6.1 Sol avec un score de 52 (en nette progression par rapport aux 48 points du précédent GPT-6 Sol).
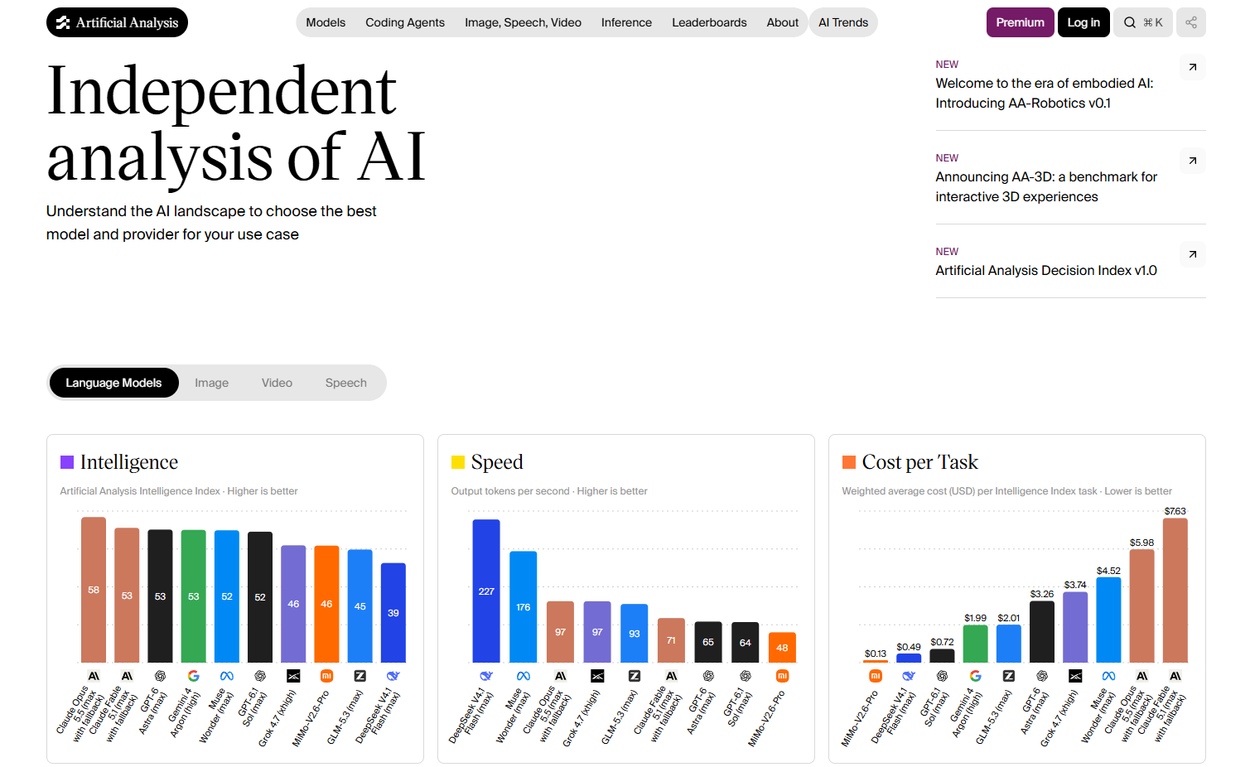
En vitesse pure à effort maximal, Opus 5.5 génère 97 tokens par seconde contre 64 tokens par seconde pour GPT-6.1 Sol, bien que la famille Sol démarre ses réponses beaucoup plus rapidement en effort moyen.
Dans le classement d’octobre de l’Agent Arena, qui évalue les modèles sur des sessions réelles d’agents autonomes, les deux rivaux dominent le marché mais se distinguent sur des critères précis :
- Plafond de réussite et programmation : Claude Opus 5.5 décroche la première place générale ainsi que le premier rang en développement (Code), discussion (Chat) et bureautique (Work), excellant notamment dans la prise en compte des corrections humaines. Il surpasse aussi GPT-6.1 Sol sur le banc d’essai scientifique Terminal-Bench Science 0.1 (63,3 % contre 57,0 %) et sur le test de maintenance logicielle FrontierCode (54,6 % contre 50,2 %).
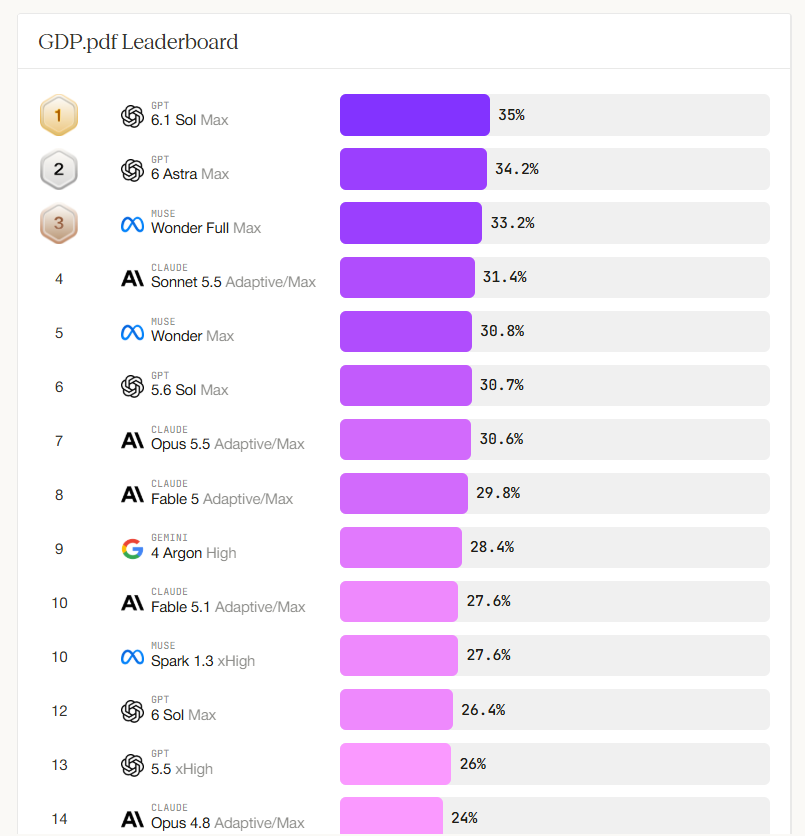
- Bureautique, documents et alignement : GPT-6.1 Sol s’adjuge la deuxième place mondiale des agents en Code et en Work (mais recule au cinquième rang en Chat). Il bat systématiquement Opus 5.5 sur l’analyse de documents complexes (35,0 % contre 30,6 % à effort maximal, sur le test GDP.pdf) et sur l’automatisation métier à effort moyen. Surtout, OpenAI domine l’indice d’alignement : GPT-6.1 Sol est le modèle le plus fiable du marché pour éviter les actions non autorisées, les fausses attributions ou les annonces trompeuses de tâches terminées, là où Opus 5.5 n’arrive qu’en sixième position.
En pratique, Opus 5.5 est à privilégier lorsque la réussite des tâches les plus difficiles prime sur le budget. GPT-6.1 Sol reste une alternative intéressante pour les opérations répétitives, les travaux bien délimités et les agents exécutant de nombreuses requêtes.
Codage, documents, agents IA : quels usages privilégier ?
Les deux modèles peuvent aider à écrire du code, corriger des bugs, analyser des documents, structurer des informations ou préparer des livrables professionnels. Ils peuvent aussi être intégrés à des agents qui utilisent des outils et enchaînent plusieurs opérations.
Pour le développement logiciel, GPT-6.1 Sol constitue un point de départ pertinent lorsqu’il faut modifier un code existant, produire des tests ou corriger des erreurs dont la résolution peut être vérifiée automatiquement. Opus 5.5 mérite d’être essayé sur les changements qui touchent de nombreux fichiers, les problèmes complexes ou les projets nécessitant plusieurs cycles de correction.
Pour l’analyse documentaire, Sol présente un avantage tarifaire important, dont les détails sont à retrouver plus bas dans cet article. Il peut servir à extraire des informations d’un ensemble de fichiers, comparer des clauses contractuelles ou préparer une synthèse à partir de documents fournis. Opus reste une option pour les analyses plus exigeantes, notamment lorsque les erreurs peuvent entraîner des conséquences importantes.
Enfin, pour un agent autonome, la qualité de la réponse finale ne suffit pas. Il faut aussi vérifier que le modèle respecte les autorisations, utilise correctement les outils et signale honnêtement les opérations qu’il n’a pas terminées. Et ce, même pour les modèles d’OpenAI, qui ont un meilleur score d’alignement mais qui peuvent tout de même poser des problèmes de sécurité.
Comment utiliser Claude Opus 5.5 et GPT-6.1 Sol ?
Pour commencer, il n’est pas nécessaire de développer un agent autonome. Les deux modèles peuvent être évalués sur une tâche concrète, avec un résultat attendu et des critères de vérification précis.
Voici une méthode simple pour les comparer :
- Définissez une tâche identique. Demandez, par exemple, de corriger un bug dans un petit projet, de comparer plusieurs documents ou de produire un rapport structuré à partir de fichiers fournis.
- Précisez le résultat attendu. Indiquez le format de sortie, les contraintes à respecter, les éléments à ne pas modifier et les critères qui permettront de vérifier le travail.
- Fournissez les mêmes données. Utilisez les mêmes fichiers, instructions et outils pour éviter de favoriser involontairement un modèle.
- Vérifiez le résultat. Pour du code, lancez les tests et contrôlez les régressions. Pour une synthèse, vérifiez les affirmations dans les documents d’origine.
- Comparez le coût total. Prenez en compte les nouvelles tentatives, les corrections manuelles et le temps de vérification, pas seulement le prix de la première réponse.
Les deux modèles proposent différents niveaux d’effort de raisonnement : low, medium, high, xhigh et max. Un effort supérieur peut améliorer les résultats sur certaines tâches, mais augmente potentiellement le temps de traitement et la consommation de tokens. GPT-6.1 Sol ne prend pas en charge les niveaux none et minimal. Chez Anthropic, la réflexion adaptative d’Opus 5.5 reste activée.
Pour une utilisation par API, les identifiants sont gpt-6.1-sol et claude-opus-5-5. GPT-6.1 Sol nécessite la Responses API d’OpenAI pour les appels d’outils ; l’API Chat Completions ne prend pas en charge cette fonction avec ce modèle. Opus 5.5 s’utilise via l’API Claude.
Quels abonnements pour utiliser ces deux modèles IA ?
GPT-6.1 Sol n’est pas disponible dans la conversation classique de ChatGPT. Au 18 octobre 2026, OpenAI le propose dans ChatGPT Work et Codex aux utilisateurs des abonnements Plus, Pro, Business, Enterprise et Edu, ainsi que via son API.
Les utilisateurs gratuits ne disposent donc pas d’un accès direct à ce modèle dans ChatGPT. Ils peuvent en revanche avoir accès au modèle inférieur GPT-6 Luna, avec des réponses interactives.
Claude Opus 5.5 est accessible dans Claude avec les abonnements Pro, Max, Team et Enterprise. Le modèle n’est pas inclus dans l’offre gratuite de Claude. Les développeurs peuvent aussi l’utiliser via l’API d’Anthropic ou des plateformes cloud compatibles.
Il faut distinguer l’abonnement à une application et l’utilisation de l’API : les abonnements donnent accès à des fonctionnalités et à des quotas selon leurs conditions, tandis que l’API facture la consommation. Un abonnement à ChatGPT ou Claude ne signifie donc pas que toutes les utilisations via API sont incluses.
API : quels prix pour les tokens ?
Les deux modèles facturent les tokens consommés en entrée et en sortie. Les tarifs standards de l’API sont les suivants, en dollars américains par million de tokens.
| Tarif API | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Tokens en entrée | 2 $ | 4 $ |
| Tokens en sortie | 10 $ | 20 $ |
| Lecture du cache | 0,10 $ | 0,20 $ |
| Fenêtre de contexte | 1,05 million | 1 million |
| Sortie maximale | 128 000 tokens | 128 000 tokens |
À consommation identique, Sol coûte donc deux fois moins cher aux tarifs standards. L’écart peut être plus important sur une tâche complète si Opus génère davantage de tokens de raisonnement.
Une exception mérite toutefois l’attention : au-delà de 272 000 tokens en entrée, GPT-6.1 Sol applique un tarif majoré à l’ensemble de la requête. Le prix de l’entrée et de la lecture du cache double, tandis que celui de la sortie est multiplié par 1,5. Opus 5.5 ne présente pas ce même seuil tarifaire dans sa grille standard.
Les prix réels dépendent donc de la longueur des requêtes, du raisonnement nécessaire, des outils employés et du nombre de tentatives. Une comparaison sérieuse doit porter sur le coût des résultats effectivement validés.
Comparatif de GPT-6.1 Sol et Claude Opus 5.5 : avantages et inconvénients
Voici un tableau comparatif pour récapituler les différents avantages et inconvénients des deux modèles, par catégorie de tâche : agents IA, traitement des longs documents, ou encore coût de l’API.
| Critère | Claude Opus 5.5 | GPT-6.1 Sol |
|---|---|---|
| Principal avantage | Performances élevées sur les tâches complexes | Coût par token inférieur |
| Programmation | Très bon sur les évaluations publiées | Bon rapport performances-prix |
| Agents IA | Premier du classement Agent Arena d’octobre | Deuxième du classement |
| Raisonnement maximal | Meilleurs résultats sur certains tests exigeants | Peut être moins performant sur les tâches les plus difficiles |
| Longs documents | Pas de majoration spécifique comparable au seuil de Sol | Surcoût au-delà de 272 000 tokens en entrée |
| Accès grand public | Claude Pro, Max, Team et Enterprise | ChatGPT Work et Codex, selon l’abonnement |
| API | 4 $ en entrée et 20 $ en sortie par million de tokens | 2 $ en entrée et 10 $ en sortie par million de tokens |
| Utilisation gratuite du modèle | Pas dans l’offre Claude gratuite | Pas dans ChatGPT gratuit |
Claude Opus 5.5 vs GPT 6.1 Sol : notre bilan en octobre 2026
Claude Opus 5.5 et GPT-6.1 Sol répondent à des besoins proches, mais le choix dépend surtout du budget et de la difficulté des tâches. Opus se distingue dans les classements d’agents IA et sur plusieurs évaluations exigeantes. Sol offre une alternative moins coûteuse, particulièrement intéressante pour les workflows répétitifs et les usages à grande échelle.
Le meilleur choix consiste à tester les deux modèles sur quelques tâches représentatives, avec les mêmes contraintes, puis à comparer les résultats validés, les corrections nécessaires et le coût total. Le modèle le plus performant sur un benchmark n’est pas forcément le plus rentable pour chaque usage.
Certains liens de cet article peuvent être affiliés.
